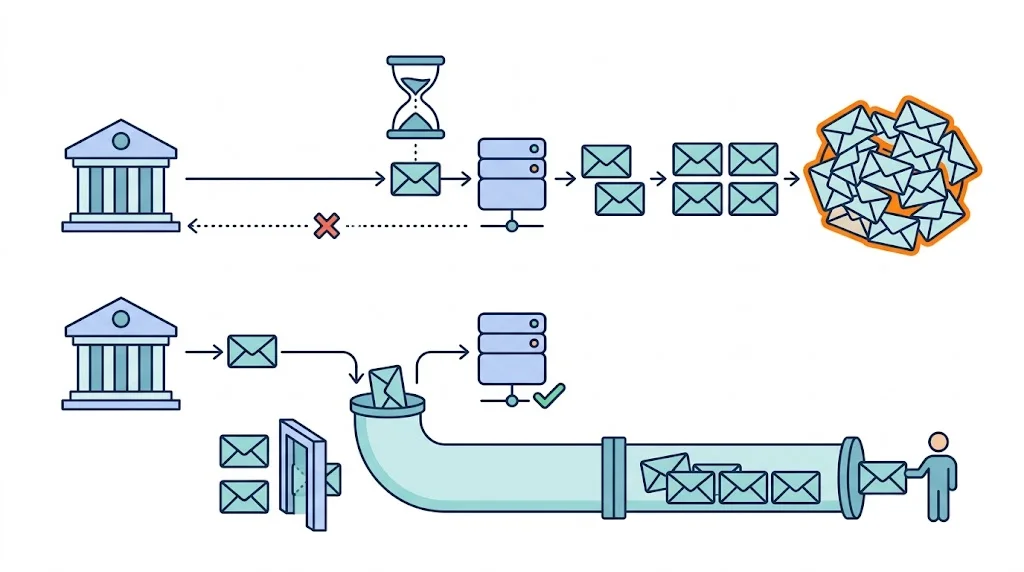
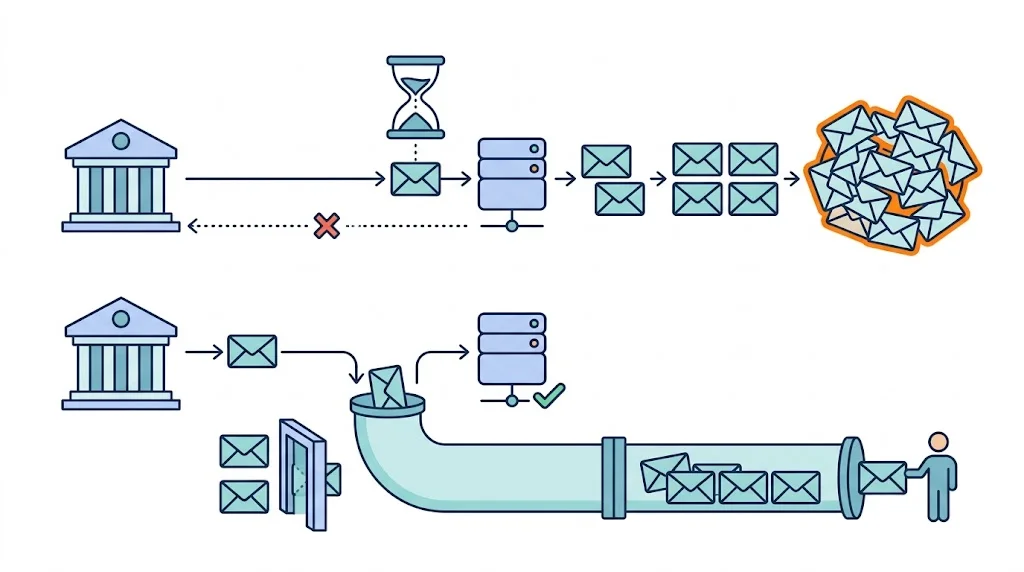
外部金流回呼打進來,你的服務當場開始算帳、寫三張表、發兩封信。做完之前,對方的逾時先到了。
它看到非 200,於是重送。你的 worker 還在處理上一筆,新的又進來。雪球從這裡開始滾:處理不完 → 超時 → 重送 → 負載更重 → 更處理不完。
擋住它只要一個動作:收下、丟進佇列、立刻回 200。真正的工作交給後面慢慢做。
這篇講在 AWS 上這個佇列該挑哪一個,以及挑完之後那兩件不做就等於沒做的事。
原理那半——為什麼要事件驅動、佇列跟串流差在哪——在 Event-driven Queue,這篇不重寫。
選型只要問四個問題
- 掉了會出事嗎? 會 → 不能用 Redis pub/sub
- 一則訊息要給幾個人? 一個 → SQS;多個 → SNS 或 EventBridge 扇出
- 需要重播歷史嗎? 需要 → Kinesis 或 MSK
- 順序重要嗎? 重要 → SQS FIFO
第一題是最容易錯的那題,所以先說清楚。
Redis pub/sub 是廣播,不是佇列。 訂閱者當下不在線,那則訊息就永遠消失了——沒有重送、沒有確認、沒有歷史。它跟 SNS 名字像、形狀像,但 SNS 有重試和死信佇列,Redis pub/sub 什麼都沒有。
把「通知會員扣款成功」這種事丟 Redis pub/sub,worker 剛好在重啟,那則通知就沒了,而且你不會知道。
選項對照
| 服務 | 一句話 | 什麼時候用 |
|---|---|---|
| SQS | 佇列,一則訊息一個消費者拿走 | 預設先選這個。背景工作、webhook 緩衝 |
| SQS FIFO | 同上,但保證順序、不重複 | 順序影響正確性時,例如同一筆訂單的狀態變更 |
| SNS | 發佈訂閱,一則複製給多個訂閱者 | 一個事件要通知好幾個下游 |
| EventBridge | 事件匯流排,可依內容過濾、可排程、可接外部 SaaS | 跨服務的領域事件 |
| Kinesis / MSK | 高吞吐串流,可重播 | 真的要重播,或每秒幾萬筆才碰 |
| Redis Streams | 輕量佇列,有消費者群組、有確認 | 已經有 Redis、規模不大 |
| Redis Pub/Sub | 廣播,會掉 | 只用在「掉了也沒差」:快取失效通知、WebSocket 推播 |
Kinesis 那一列要特別克制。每秒幾萬筆以下、不需要重播的場景選它就是過度設計。選了它,你會換來一整套運維,去解一個你沒有的問題:分片管理(資料流切成幾段平行處理,切幾段要自己管)、消費者位移(每個消費者讀到哪一筆,要記下來)、重新平衡(消費者增減時,重新分配誰讀哪一段)。
為什麼是三個服務不是一個
這三個不是同代的替代品,是每一代撞牆之後長出來的。
SQS 先解「同步做不完」。 一則訊息一個消費者拿走,工作被推到後面去,前面就不會塞住。
但 SQS 撞的牆是一則只能給一個人。訂單成立要同時通知點數、會員、推播,你得在程式裡發三次,而且每加一個下游就要改一次發送端的 code。
SNS 解這面牆:發一則,複製給所有訂閱者。發送端不用認識下游。
SNS 自己的牆是只能照 topic 分流。下游說「我只要金額大於一萬的訂單」,SNS 給不了,它只能把全部推過去讓你自己濾——那些不該來的訊息還是消耗了你的 worker。
EventBridge 解這面:規則可以看訊息內容過濾,還附帶排程和外部 SaaS 接點。
EventBridge 也有牆,而且它是本段裡唯一還沒被解掉的:它不保存歷史。新的訂閱者加進來,只看得到從現在開始的事件,之前的看不到。要重播就得往 Kinesis 或 Kafka 走,代價是前面講的那整套運維。
四個落點
以「ALB + ECS + 外部金流」這類架構為例,非同步該出現在這四個地方。
webhook 收到就丟佇列
外部回呼 → ALB → 服務收下 → 丟 SQS → 立刻回 200
                                   ↓
                              worker 非同步處理
開頭那顆雪球就是這樣擋掉的。這是四個落點裡最該先做的一個。
把排程從單台機器解耦
很多架構裡有一台 EC2 跑 cron。那是單點——掛了沒人接手,也擴不了。
EventBridge 定時 → 丟訊息進 SQS → ECS worker 消化搬之前先處理那台機器上的本地狀態,不然搬完會發現 worker 讀不到檔案。
跨服務的領域事件
訂單成立要通知點數、會員、推播。同步一個一個呼叫的話,服務之間就得互相認識——在 ECS 上還得繞 ALB 才找得到對方。
改成發一個事件、各自訂閱,耦合就降下來了。這是 EventBridge 的主場。
快取失效廣播
這個剛好適合 Redis pub/sub。掉了下次讀自然重建,沒差。
前面說 Redis pub/sub 會掉是缺點,在這裡它是可以接受的代價——差別在於這件事掉了不會有人受傷。
兩個配套,不做等於白做
死信佇列
處理失敗超過 N 次就丟進去的另一個佇列。SQS 內建,設定就好。
沒有它,壞訊息會無限重試,把 worker 佔滿。 一則永遠解析失敗的訊息可以讓整條佇列停擺。
死信佇列只要有東西就該告警——那裡本來就不該有東西。這跟一般的「超過門檻才告警」不同,門檻是零。
冪等:做幾次結果都一樣
SQS 是「至少送一次」。重複是正常現象,不是故障。
這句話在金流場景的意思是:沒做冪等就會重複扣款。不是可能會,是遲早會。
實作上就是拿訊息 ID 或訂單編號當去重鍵,用原子操作標記:SET NX(key 不存在才寫入;「檢查有沒有」和「寫入」一步完成,中間不會被別人插隊)成功才執行副作用,失敗代表別人已經做過了。marker 要設明確的 TTL,不然 Redis 會被去重鍵塞滿。
順序也一樣。SQS 標準佇列不保證順序,所以「先建立後取消」可能以相反順序到達你的 worker。需要順序就用 FIFO,但要先知道它的代價。
FIFO 的代價
FIFO 買到順序和去重,付出的是吞吐上限。依 AWS 文件(2026-09-20 查證):
- 一般模式(沒開高吞吐模式)下,送、收、刪每種動作每秒 300 筆
- 一般模式下開啟批次(一次呼叫最多帶 10 則),每種動作每秒最多 3,000 則,也就是 300 次呼叫 × 10 則
- 訊息大小上限 1 MiB,保留最長 14 天
- 可見性逾時最長 12 小時(訊息被一個消費者拿走後,對其他人隱藏多久;時間到還沒刪掉,就會重新出現給別人拿)
300 筆不夠用,要開高吞吐模式(high throughput FIFO)。這裡要先認識 FIFO 的一個欄位:訊息群組 ID(MessageGroupId),送訊息時由你指定,同一個群組 ID 裡的訊息保證照順序處理。開了高吞吐模式之後,吞吐上限改成照訊息群組 ID 分散計算。SQS 把群組 ID 拿去 hash,決定訊息存進哪個分區(partition,SQS 內部存訊息的單位);每個分區各自有上限(官方文件)。所以全部訊息塞同一個群組 ID,開了也沒用,全擠在同一個分區。用訂單編號當群組 ID,不同訂單才會分散開、彼此並行。
(官方兩頁說法有出入:配額頁寫一般模式的 300 是「每個分區」,開啟高吞吐的設定頁寫一般模式的配額算在整條佇列。估容量時照比較保守的「整條佇列 300」算。)
自架 vs AWS
自己架 RabbitMQ 或 Kafka,你要管叢集、磁碟水位、分區重新平衡、消費者延遲監控。SQS 這些全不用管,也沒有「佇列機器掛了」這件事。
代價是你放棄了細節控制。RabbitMQ 的路由規則、Kafka 的壓縮主題(compacted topic,同一個 key 只保留最新一筆),SQS 都沒有對應物。真的需要那些,就是該自架或用 MSK 的時候。
K8s 映射
在 K8s 上這套的對應物通常是自架 RabbitMQ 或 Redis Streams,配 KEDA 依佇列長度自動擴 worker。
AWS 這邊對應的是 SQS 加 ECS Service Auto Scaling,指標用 ApproximateNumberOfMessagesVisible。
冪等和死信佇列那兩條在 K8s 一模一樣——換平台不會讓重複扣款消失,那是訊息模型帶來的,不是雲廠商帶來的。
相關文章
- 上一篇 安全,回 AWS 系列目錄
- 佇列的原理與選型概念:Event-driven Queue
- 佇列長度、消費者延遲怎麼看: X-Ray
- Redis 本身的三種投遞模型:Replication、Failover、Cluster、讀寫分離
非同步不是效能優化,是把「做不完」跟「回不了」這兩件事拆開。前者慢慢解決,後者不能等。