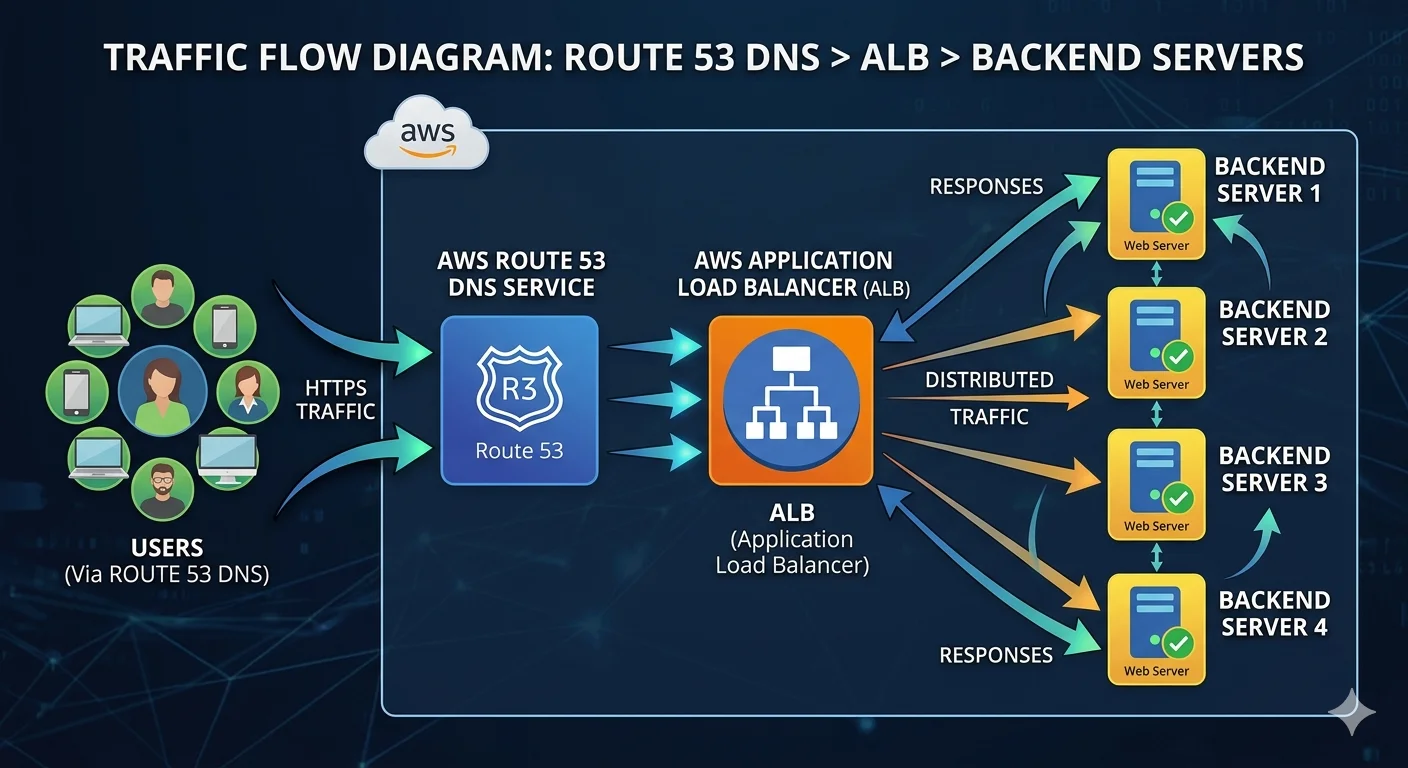
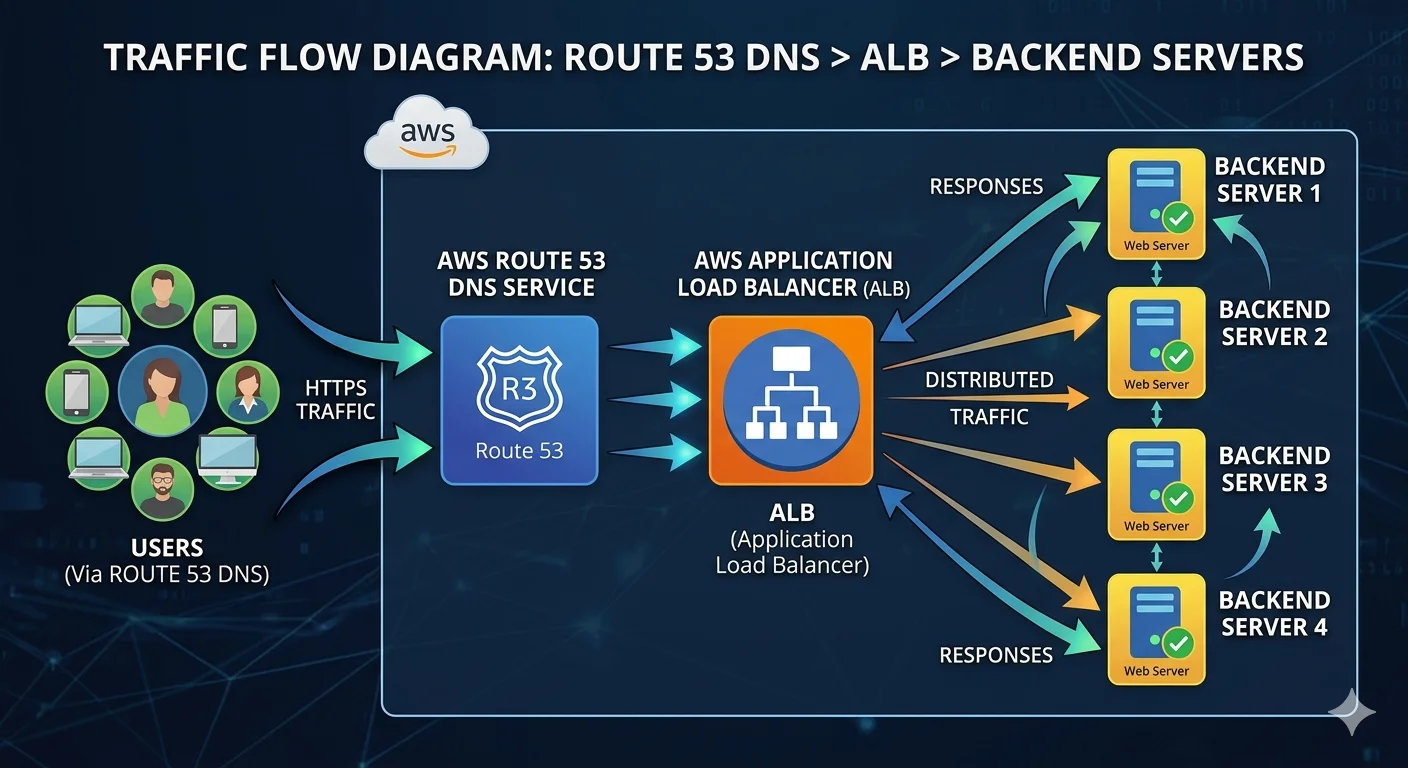
你的 App 跑起來了,使用者怎麼連進來?直接打 EC2 的 public IP 是玩具階段,生產環境是 ALB + DNS。但 ALB 建起來只要十分鐘,建好之後的預設值才是問題。
結論:建 ALB 很快,改預設值才是功課
選型三句話:HTTP 用 ALB;需要固定 IP、非 HTTP 協定、或極低延遲才用 NLB;Route 53 的價值不在 DNS,在 health check 加 failover。
然後是五個預設值,每一個我都在真實架構圖或官方文件裡撞過:
- Health check 預設連續 5 次、每 30 秒——新 task 至少 150 秒才收流量
- Deregistration delay 預設 300 秒——滾動更新每換一台等五分鐘
- Idle timeout 預設 60 秒——大檔上傳、長輪詢直接被切
- 一個 ALB 最多 100 個 target group,不可調——「一個 ALB 掛所有服務」有天花板
- 加了 CloudFront + WAF,ALB 本身還是公開的——攻擊者直打 ALB 就繞過 WAF
一、建 ALB:三步,加上第一批要改的預設值
ALB 在第七層,看得懂 HTTP,所以能依 host 和 path 分流。建起來三步:ALB 本體、target group、listener。
aws elbv2 create-load-balancer --name prod-alb --type application \
  --subnets subnet-public-1a subnet-public-1c --security-groups sg-alb

aws elbv2 create-target-group --name app-tg \
  --protocol HTTP --port 8080 --vpc-id vpc-xxx --target-type ip \
  --health-check-path /health \
  --health-check-interval-seconds 10 \
  --healthy-threshold-count 2 \
  --unhealthy-threshold-count 3

aws elbv2 create-listener --load-balancer-arn arn:aws:...:loadbalancer/app/prod-alb/xxx \
  --protocol HTTPS --port 443 \
  --certificates CertificateArn=arn:aws:acm:...:certificate/xxx \
  --default-actions Type=forward,TargetGroupArn=arn:aws:...:targetgroup/app-tg/xxx
注意 target group 那段我沒有用預設值。官方文件寫的預設是:
| 設定 | 預設 | 我改成 | 為什麼 |
|---|---|---|---|
| 間隔 | 30 秒 | 10 秒 | 預設太慢,壞掉的 task 要一分鐘才被踢 |
| 連續幾次成功才算健康 | 5 次 | 2 次 | 5 × 30 = 150 秒,新 task 起來後兩分半才收流量 |
| 連續幾次失敗才算不健康 | 2 次 | 3 次 | 避免一次網路抖動就踢人 |
| 路徑 | / | /health | 首頁可能很重、可能打到資料庫 |
第二列是這篇最重要的一行。 我這次對著文件算才發現:自動擴容「決定要擴」到「新 task 真的在服務」之間那段分鐘級的延遲,有一大塊就是這個 150 秒。改成 2 × 10 = 20 秒,擴容體感差很多。
Health check 的路徑要輕——只確認程式活著,不要查資料庫。查資料庫的話,資料庫一慢所有 task 全部被判不健康,然後你會撞到下一節講的 fail-open。
我自己踩過的雷:health check 的 port 預設跟 target 收流量的 port 一樣,App 在 8080 但 health endpoint 在 8081 的話要另外設。
二、Deregistration delay 與 idle timeout:兩個等待時間
Deregistration delay(target 要下線時,ALB 等它把手上的請求做完的時間)預設 300 秒。滾動更新換 10 個 task,每個等 5 分鐘。
aws elbv2 modify-target-group-attributes --target-group-arn arn:aws:...:targetgroup/app-tg/xxx \
--attributes Key=deregistration_delay.timeout_seconds,Value=30但不能設太短——文件明講:target 在 delay 結束前就斷連線,client 會收到 5xx。這個數字要跟 ECS 的 stopTimeout 和你程式的 graceful shutdown 時間對齊:ALB 先停送新請求 → 等 delay → 程式收到 SIGTERM 做完手上的事 → 退出。三個時間對不上,滾動更新就是每次掉幾個請求。
Idle timeout(連線上沒有資料流動多久後 ALB 切掉它)預設 60 秒。大檔上傳、長輪詢、報表匯出——只要 60 秒沒動就斷。
aws elbv2 modify-load-balancer-attributes --load-balancer-arn arn:aws:...:loadbalancer/app/prod-alb/xxx \
  --attributes Key=idle_timeout.timeout_seconds,Value=300
WebSocket 不受這條影響(升級後的連線 ALB 會一直維持),但 health check 不支援 WebSocket,所以 WebSocket 服務的 health check 要另開一個普通的 HTTP 端點。
三、Fail-open 與 subnet 的 IP:兩個「全掛」的樣子
Fail-open:官方文件寫得很清楚——target group 裡所有 target 都不健康時,ALB 會把流量送給全部 target,無視健康狀態。
這代表:你的 health check 如果會打資料庫,資料庫一慢 → 全部 task 被判不健康 → ALB 不是回 503 給使用者,而是照樣把請求送進去——使用者看到的是應用層各種奇怪的錯誤,而你的監控看不到「ALB 沒有健康 target」這個訊號。這就是第一節說 health check 要輕的原因。
Subnet 的 IP:ALB 在每個啟用的 AZ 放一個節點,擴容時要在 subnet 裡拿 IP。文件要求每個 subnet 至少 /27 而且留 8 個可用 IP;不夠的話 ALB 擴不動,舊節點還在服務,但擴容卡住會產生 5xx 或逾時。public subnet 只放 ALB 和 NAT(見 第 2 篇)的另一個理由就在這——別讓其他東西把 IP 吃光。
四、一個 ALB 掛所有服務的天花板
這段是我整理一份實際專案的 AWS 架構圖時看到的:所有服務掛在同一個 ALB,用 host 分流;而且服務之間互相呼叫也走這個 ALB——因為 ECS 預設沒有 K8s 那種 cluster 內的服務發現,走 ALB 是最好懂的第一版。
兩個天花板:
硬的:官方配額——一個 ALB 最多 100 個 target group,不可調整。Listener rule 預設 100 條可以申請調高,target group 不行。每個服務一個 target group、藍綠部署再各一個,很快就到。
軟的:東西向流量繞 ALB 有三重代價——多一跳延遲(p99 變差)、吃 ALB 容量、ALB 按用量計費(LCU)所以帳單跟著翻。低流量沒感覺,流量上去之後這是第一個要還的架構債,解法是 ECS Service Connect 或內部服務發現,讓服務之間直連。
路由規則本身很簡單:
aws elbv2 create-rule --listener-arn arn:aws:...:listener/xxx --priority 10 \
  --conditions Field=host-header,Values='api.example.com' \
  --actions Type=forward,TargetGroupArn=arn:aws:...:targetgroup/api-tg/xxx
五、加了 CloudFront,ALB 還是公開的
CloudFront + WAF 擋在前面,但 internet-facing 的 ALB 有自己的公開 DNS 名稱——攻擊者直接打 ALB 的網址就繞過 WAF 了。官方文件給的做法是兩層:
- CloudFront 加一個自訂 header(名稱和值都要當密碼保管、定期輪替),ALB 的 listener 只轉發帶這個 header 的請求,預設規則改成回 403。
- SG 只允許 CloudFront 的 managed prefix list——在網路層就擋掉不是從 CloudFront 來的。
兩層都做。只做第一層,header 洩漏就破功;只做第二層,同帳號其他 CloudFront distribution 也進得來。
如果 ALB 可以不對外,用 CloudFront 的 VPC origin 接內部 ALB,連公開 DNS 都沒有,最乾淨。
NLB 與 Route 53:各一段
NLB 在第四層,只看 TCP / UDP。三種情況才用它:對方要你固定 IP做白名單(NLB 每個 AZ 可綁一個 EIP,ALB 不行)、非 HTTP 協定、或延遲敏感到 HTTP 解析都嫌多。其他時候 ALB。
Route 53 用 Alias record 指向 ALB,開 EvaluateTargetHealth——ALB 沒有健康 target 時 DNS 就不回那筆。這才是 Route 53 的價值:配 failover 路由策略,主區域掛了自動指向備區域。Weighted 策略可以做 DNS 層的 canary,但 DNS 有快取,切換不精確,正式的 canary 在 ALB 的 weighted target group 做。
ACM:自動續期有一個前提
ACM 憑證免費、自動續期,但官方文件的原話是:「只要憑證在使用中、而且 CNAME 驗證記錄還在,ACM 就會自動續期」。
反過來說:驗證用的 CNAME 被刪了、DNS 搬家沒搬到、網域轉移——續期就無聲失敗。到期那天才知道。用 email 驗證的憑證不能改成 DNS 驗證,要重新申請。
aws acm request-certificate --domain-name "*.example.com" \
  --validation-method DNS --subject-alternative-names "example.com"
拿到 CNAME 後加進 Route 53,之後永遠不要刪那筆記錄。給 CloudFront 用的憑證要在 us-east-1 申請,ALB 的在 ALB 所在區域申請——兩張。
實戰 Checklist
- Health check:間隔 10 秒、2 次成功、3 次失敗、路徑
/health且不碰資料庫 - Deregistration delay 對齊 ECS
stopTimeout和程式的 graceful shutdown - Idle timeout 依最長的請求調,別用 60 秒預設
- 算過 target group 數量離 100 有多遠;服務間呼叫不走 ALB
- ALB 前有 CloudFront 的話,自訂 header + prefix list 兩層都鎖;ACM 的驗證 CNAME 永遠不刪
從 K8s 過來的話
ALB 就是 Ingress controller,target group 是 Endpoints,health check 是 readinessProbe——但兩層是分開的:容器的 healthCheck 和 target group 的 health check 各自設定,容器活著但 target group 判不健康,服務照樣沒流量。K8s 那邊 readiness 一個地方管完,這裡要看兩處。
在 EKS 上用 AWS Load Balancer Controller 可以讓 Ingress 自動建 ALB,上面五個預設值變成 Ingress 的 annotation。細節在 K8s 網路模型。
相關文章
- 上一篇 EKS,下一篇 S3
- ALB 前面的網段和 SG:VPC 網路
- ALB 的 LCU 帳單怎麼算:成本管理
- 自架的對照:Reverse Proxy + TLS、DNS、負載均衡與 CDN
Load Balancer 是使用者跟你的服務之間的第一道關卡——它掛了,後面再健康都沒用。