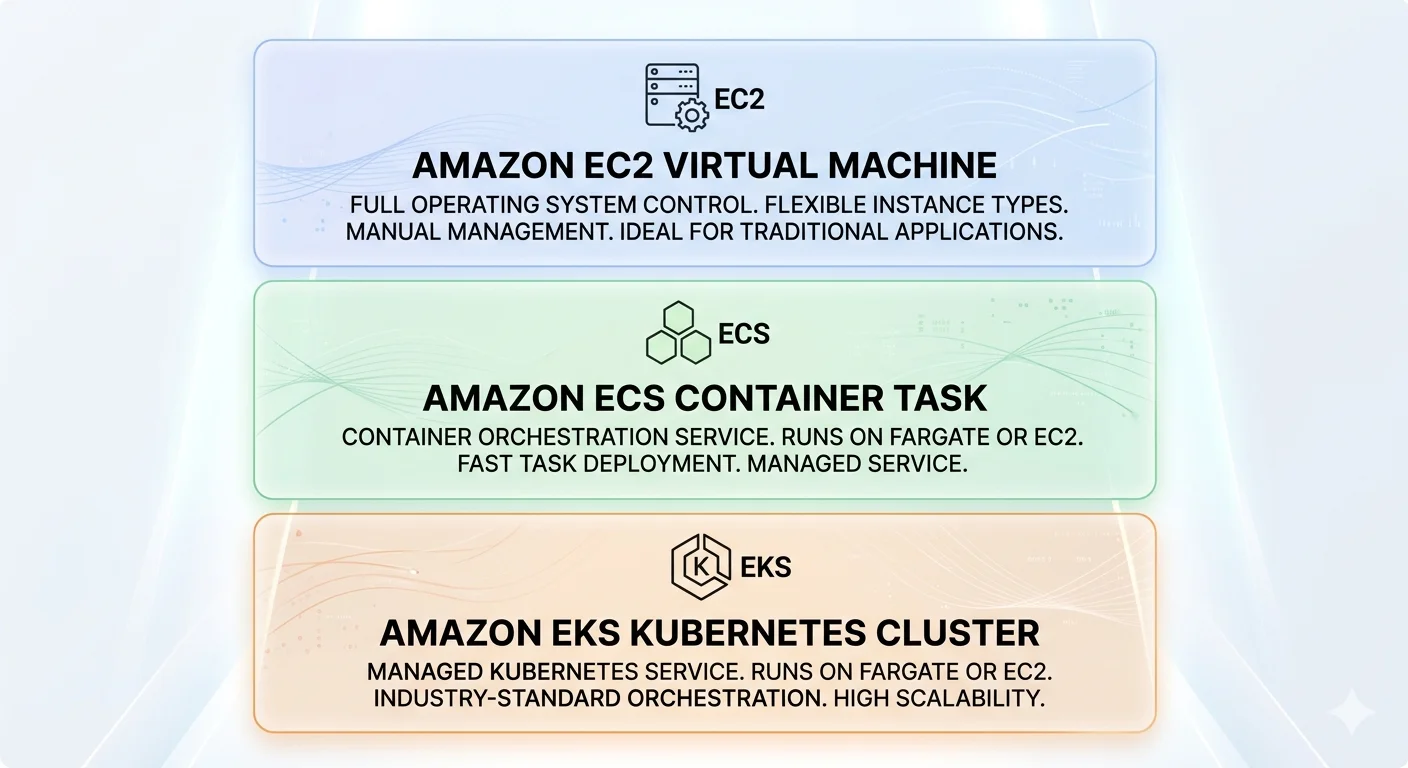
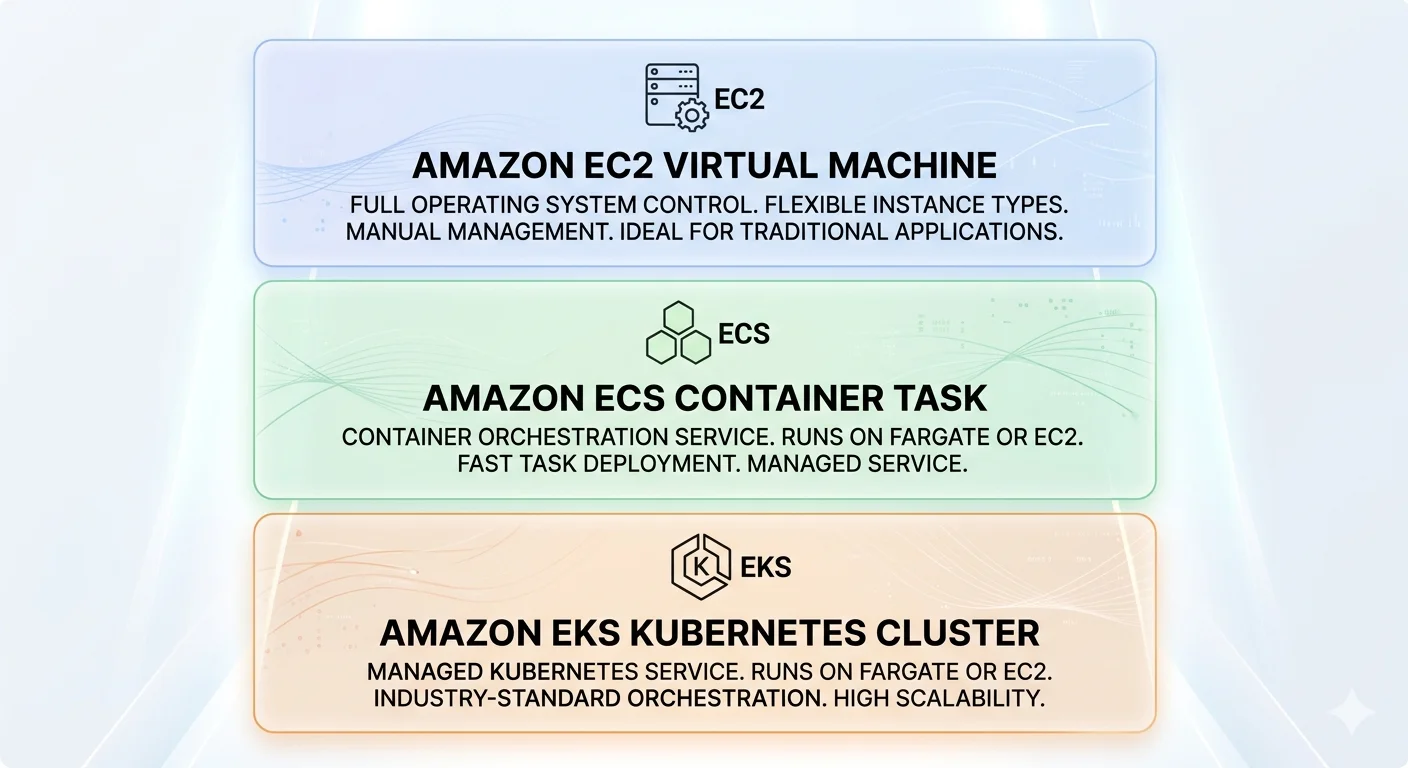
你有一個容器化的 App,打開 Console 看到 EC2、ECS、EKS 三個選項。真正的問題不是選哪個——是選完 ECS 之後,還有一個沒人告訴你要選的東西。
結論:兩個決策,第二個很少有人提
決策一:ECS 還是 EKS。 團隊會 K8s、或者要多雲,才選 EKS。其他情況 ECS。我的判斷是:除非你有很強的理由選 EKS,否則 ECS 是最省心的選擇——EKS 的 overhead 不只是錢,還有學習成本和維運複雜度。
決策二:Fargate 還是 EC2 launch type。 選了 ECS 之後,task 跑在哪?Fargate 是「不管機器」,EC2 是「自己管一群 EC2 當容器主機」。預設 Fargate,三種情況才 EC2(第二節)。
然後是四個建 service 時就要對的設定,每一個都連到後面幾篇會撞的坑(第三節)。
不容器化的 App 才直接跑 EC2——而且不要再用 PEM + SSH,最後一節講。
一、ECS 的四個概念,對 K8s 的人怎麼翻譯
| ECS | K8s | 心智要調的地方 |
|---|---|---|
| Task | Pod | 最小排程單位,可含多容器(官方配額每個 task definition 最多 10 個容器) |
| Task Definition | Pod template | 不可變、有 revision 版本號——改一個環境變數就是新 revision,不是就地改 spec |
| Service | Deployment | 管 desired count 和滾動更新,中間沒有 ReplicaSet 那層 |
| RunTask | Job | 一次性跑完就結束。把 Task 對到 Job 是常見的錯 |
翻譯完之後,五個 K8s 有、ECS 沒有的東西——每個都會咬人,細節散在各篇:
- 沒有 cluster 內服務發現(沒有 ClusterIP)——服務互打要繞內部 ALB 或用 Service Connect,第 4 篇講代價
- 沒有 namespace——環境隔離往上搬一層,一環境一帳號或一 VPC
- Ingress 拆成兩半——ALB 在 cluster 外,路由規則是 AWS 資源不是 YAML
- 沒有 DaemonSet——Fargate 上不可能,log 和 trace 全變 sidecar,第 7 篇
- 出口 IP 這件事你可能沒管過——第三方要白名單就決定了整個網段切法,第 2 篇
二、Fargate 還是 EC2 launch type
Fargate:官方定義——不用配置或擴縮 EC2,每個 task 有自己的隔離邊界、不跟其他 task 共用 kernel。你給 CPU 和記憶體,按用量計費。
EC2 launch type:你自己開一群 EC2 註冊進 cluster,task 排在上面跑。你管 AMI 升級、管 capacity provider、管機器塞滿沒。
預設選 Fargate,除了這三種情況:
- 要碰 host——GPU、privileged 容器、host 網路。官方明講 Fargate 不支援所有 task definition 參數,需要 host 資源的工作負載就是那些。
- 啟動速度是命——促銷開賣那種瞬間尖峰。Fargate 每次起 task 都要拉 image;EC2 上 image 可以預拉在機器裡,秒起。
- 穩定大量負載要省錢——EC2 可以用 Reserved / Spot 把機器塞滿;Fargate 按 task 算,塞不了。
Fargate 三件要知道的:
- 新帳號預設只有 6 個 vCPU(配額,會依用量自動放寬)——第一次上線最容易撞到,有已知尖峰就先申請
- AWS 會主動退役你的 task:平台版本有安全漏洞時,AWS 出新版並「退役跑在舊版上的 task」。所以 task 永遠跑在 service 底下,退役了 service 會補;用 RunTask 裸跑的一次性 task 被退役就沒了
- target group 的 target type 必須是
ip不是instance——task 綁的是網卡不是機器,選錯 ALB 找不到它
三、建 service 時就要對的四個設定
aws ecs create-service --cluster prod-cluster --service-name web-app \
  --task-definition web-app:1 --desired-count 2 --launch-type FARGATE \
  --network-configuration "awsvpcConfiguration={subnets=[subnet-private-1a,subnet-private-1c],securityGroups=[sg-app],assignPublicIp=DISABLED}" \
  --load-balancers "targetGroupArn=arn:aws:...:targetgroup/app-tg/xxx,containerName=app,containerPort=8080" \
  --deployment-configuration "deploymentCircuitBreaker={enable=true,rollback=true}" \
  --capacity-provider-strategy '[{"capacityProvider":"FARGATE","weight":1,"base":1},{"capacityProvider":"FARGATE_SPOT","weight":3}]'
1. stopTimeout(在 task definition 的容器層):ECS 送 SIGTERM 到 SIGKILL 之間等多久。官方文件:預設 30 秒,上限 120 秒。你的程式 graceful shutdown 要 45 秒,預設就是每次部署被硬殺。這個數字要跟 ALB 的 deregistration delay 對齊,第 4 篇。
2. Health check 兩層:容器的 healthCheck 和 target group 的 health check 是兩個獨立設定。容器活著但 target group 判不健康,服務照樣沒流量;只設容器那層,斷路器第二階段看的是 ALB 那層。兩層都設。
3. 斷路器 rollback=true:部署起不來自己退回上一版。第 10 篇講它的兩階段判定和「沒有 COMPLETED 可回就卡住」。
4. Capacity provider 混 Spot:base=1 保證至少一個 task 在 On-Demand,其他走 Fargate Spot——官方寫的是兩分鐘前通知後收回。適合 worker,不適合對外服務的全部 task。第 11 篇。
擴容指標不要用 CPU——那是落後指標,CPU 高的時候使用者已經在等了。用 ALB 的每台請求數當目標:
aws application-autoscaling put-scaling-policy --service-namespace ecs \
  --resource-id service/prod-cluster/web-app --scalable-dimension ecs:service:DesiredCount \
  --policy-name request-tracking --policy-type TargetTrackingScaling \
  --target-tracking-scaling-policy-configuration \
    'TargetValue=500,PredefinedMetricSpecification={PredefinedMetricType=ALBRequestCountPerTarget,ResourceLabel=app/prod-alb/xxx/targetgroup/app-tg/yyy}'
而且擴容快不快有一半不在這裡,在 health check 的預設值——新 task 要過連續 5 次、每 30 秒的檢查才收流量,第 4 篇算過那是 150 秒。
四、EKS:如果你真的需要,三件 K8s 沒有的事
EKS 是完整的 K8s,你會的都能用。但有三件自架 K8s 不會發生的事:
1. 版本會被強制升級。 官方生命週期:每個版本標準支援 14 個月,延長支援再 12 個月(要加錢,而且預設開著)。延長期結束,AWS 自動升級你的 control plane,事前不通知。自架 K8s 你可以卡在某版一年不動,EKS 不行。而且只升 control plane,managed node group 不會跟著升——你要自己補。這條要進到期清單,第 12 篇。
2. 每個 Pod 吃一個 VPC IP。 VPC CNI給每個 Pod 分配一個 VPC 的 IP,每台 node 能跑幾個 Pod 受它能掛幾張網卡限制。Subnet 給 /24 只有 256 個 IP,Pod 一多就分不到——這是 第 2 篇說 CIDR 一開始就要給大的另一個理由,EKS 比 ECS 吃 IP 吃得兇很多。
3. Pod 的 AWS 身分。 IRSA 或較新的 Pod Identity,第 8 篇。
eksctl create cluster --name prod-cluster --region ap-northeast-1 \
  --vpc-private-subnets subnet-private-1a,subnet-private-1c \
  --nodegroup-name workers --node-type t3.medium --nodes 3 --managed
五、直接跑 EC2:不容器化才選,而且別再 SSH
App 沒容器化、或有特殊 OS 需求,才直接跑 EC2。老派做法是 PEM 檔 + SSH——不要。PEM 弄丟只能重建、開 22 port 是攻擊面、誰用過 key 沒有紀錄。
用 SSM Session Manager:不開任何 port、不發 key、每次連線 CloudTrail 有紀錄、能用 IAM 管誰可以連。
# 機器裝 SSM agent(Amazon Linux 預裝)+ instance role 掛 AmazonSSMManagedInstanceCore,然後:
aws ssm start-session --target i-0123456789abcdef0
Instance type 選法看官方型號頁,這篇不列規格表——那些數字會變。
這篇的驗證標準
| 主張 | ❌ 不算 | ✅ 算 |
|---|---|---|
| Graceful shutdown 有效 | stopTimeout 設了 | 部署期間持續打流量,零 5xx |
| Task 會自己補 | 跑在 service 底下 | 手動 stop 一個 task,看 service 在預期時間內補回 |
| 擴容來得及 | 有 scaling policy | Spike test 實測「觸發到服務」的秒數 |
| EKS 版本有人盯 | 知道會自動升 | 到期清單上有 EKS 版本和 end-of-support 日期,提前 90 天告警 |
實戰 Checklist
- 決策二做了:Fargate 為預設,EC2 launch type 有明確理由才用
-
stopTimeout對齊程式的 shutdown 時間,且 ≤ 120 秒 - Health check 兩層都設;斷路器
rollback=true;Spotbase=1 - 擴容用
ALBRequestCountPerTarget不用 CPU;health check 門檻改短 - EKS 的話:CIDR 給夠、版本到期日進清單、node group 升級排進去
從 K8s 過來的話
整篇都是。補一句:ECS 不是「簡化版 K8s」,是「砍掉一半、剩下交給 AWS」——砍掉的那一半(namespace、ClusterIP、DaemonSet、Operator 生態)你會想念,但換來的是不用管 control plane、不用管升級、不用管 CNI。要不要這個交換,看決策一。細節在 K8s Workloads。
相關文章
- 上一篇 VPC 網路,下一篇 Route 53
- 四個設定連到的坑:負載平衡(deregistration、health check)、CD(斷路器)、成本(Spot)
- 概念層:Container Runtime、Compose vs K8s
選 compute 方案就像選車——不是最貴的最好,是最適合你的路況的最好。但先確定你知道車有幾個檔位。