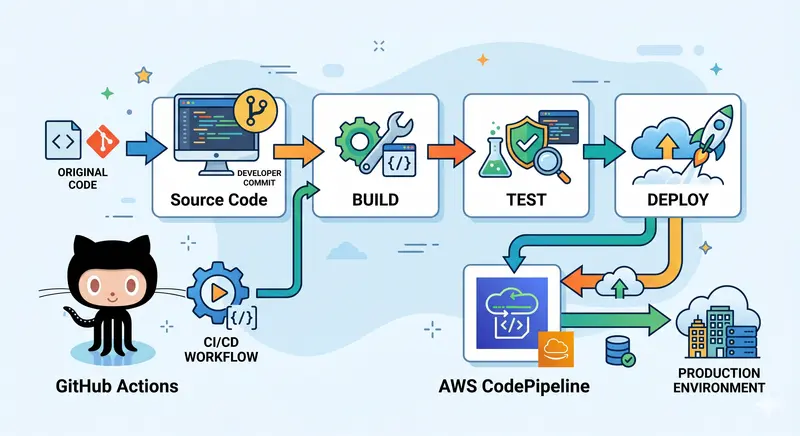
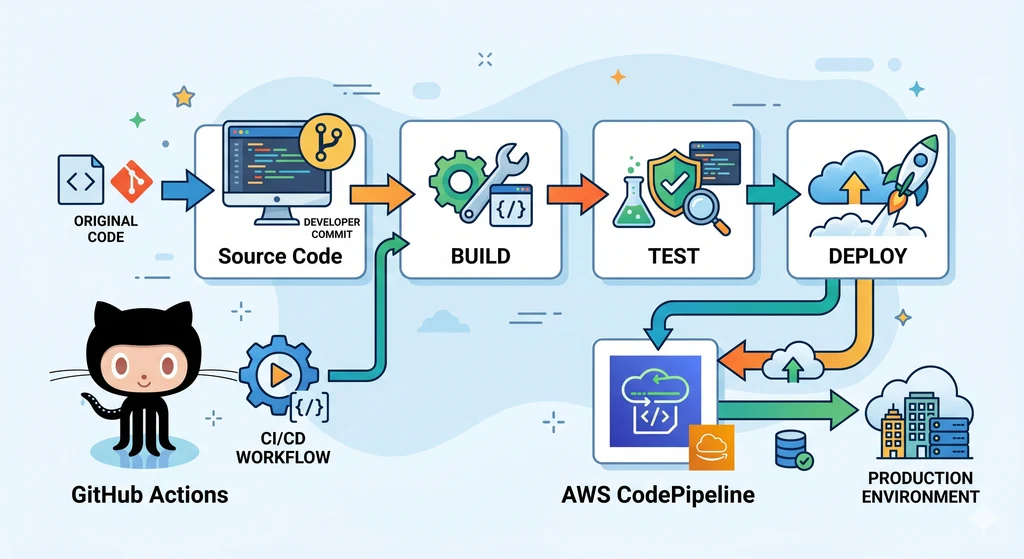
你的 code push 了,然後手動 SSH 進去拉 code、重啟服務?都 2026 年了。但自動化之後有另一種痛:部署壞了,你發現「回滾」按鈕其實是裝飾品。
結論:工具選對了,鏈還是斷的
工具:code 在 GitHub 就用 GitHub Actions,用 OIDC 拿臨時憑證,不存 access key。CodePipeline 只在兩種情況選(最後一節)。
但重點不在工具,在這條鏈的每一段能不能退:
① build → ② 推 registry → ③ migration → ④ deploy → ⑤ 驗證
   每一段都要能回答「壞了怎麼退」
多數 CI/CD 教學只畫了 ①②④,③ 消失、⑤ 沒有,而 ④ 的退路是假的。
① Build:版本要能指回原始碼
image tag 用 git SHA,不用 latest、不用日期。回滾就是「把上一版部回去」——latest 沒有上一版,它永遠是現在這版。
env:
  IMAGE_TAG: ${{ github.sha }}
run: |
  docker build -t $ECR_REGISTRY/$ECR_REPOSITORY:$IMAGE_TAG .
  docker push $ECR_REGISTRY/$ECR_REPOSITORY:$IMAGE_TAG
常見做法是多推一份 :latest 給人看「現在是哪版」——不要。要看現在是哪版,看 ECS service 指的 task definition revision 裡的 image tag,那才是事實。
② Registry:讓 ECR 幫你擋住覆蓋
三個設定,建 repository 時一起開:
aws ecr create-repository --repository-name web-app \
  --image-tag-mutability IMMUTABLE \
  --image-scanning-configuration scanOnPush=true

aws ecr put-lifecycle-policy --repository-name web-app --lifecycle-policy-text \
  '{"rules":[{"rulePriority":1,"description":"keep last 20",
    "selection":{"tagStatus":"any","countType":"imageCountMoreThan","countNumber":20},
    "action":{"type":"expire"}}]}'
不可變 tag:官方文件——開了之後,推一個已存在的 tag 會回 ImageTagAlreadyExistsException。這是防「我以為部的是那版」唯一硬的手段。真的需要一個會動的 tag(例如給本機開發拉的),用 IMMUTABLE_WITH_EXCLUSION 單獨排除它,正式部署永遠不用那個 tag。
生命週期規則:舊 image 自動清,但保留最近 N 版——那是回滾用的。清太狠,回滾時 image 已經不在了。
④ Deploy:不是 force-new-deployment,是換 revision
常見的部署指令是:
aws ecs update-service --cluster prod --service web-app --force-new-deployment # ❌這行的意思是「用現在的 task definition 重起 task」。task definition 指 latest → 起的是最新 image;task definition 指 SHA → 起的是舊的那個 SHA,你的新版根本沒部上去。兩種情況都不對。
正確的是註冊新的 task definition revision、指向新 SHA、再更新 service:
- name: Render task definition with new image
  id: render
  uses: aws-actions/amazon-ecs-render-task-definition@v1
  with:
    task-definition: task-def.json
    container-name: app
    image: ${{ env.ECR_REGISTRY }}/${{ env.ECR_REPOSITORY }}:${{ github.sha }}

- name: Deploy
  uses: aws-actions/amazon-ecs-deploy-task-definition@v1
  with:
    task-definition: ${{ steps.render.outputs.task-definition }}
    service: web-app
    cluster: prod-cluster
    wait-for-service-stability: true
這樣每次部署產生一個新 revision,revision 裡的 image tag 是 SHA。回滾 = 指回上一個 revision,而那個 revision 的 image 真的是上一版。
三種策略,ECS 現在都有原生的
- 滾動(ECS 預設):一批一批換 task,回滾就是部上一個 revision。預設選這個。
- 藍綠:整套新版起好,一次切流量,回滾是切回舊版。要在切流量前先驗過新版時選它。
- 金絲雀:先給一小部分流量看指標,不對就停止推進。前提是流量夠大,指標才有統計意義。
藍綠不再一定要 CodeDeploy。 AWS 在 2025 年 7 月公告 ECS 內建藍綠部署,支援 ALB、NLB 和 Service Connect(ECS 管服務之間互相呼叫的機制)。它還有 lifecycle hook,也就是部署流程中途的掛勾點:在切流量前後停下來,用 Lambda 或暫停點跑驗證。開發者指南寫了代價:藍綠期間新舊兩版同時在跑,資源用量可能暫時翻倍。好處是舊版會留到 bake time 結束,回滾很容易。bake time 是切到新版之後、舊版還留著待命的那段觀察期。
2025 年 10 月再補上原生的 linear 和 canary。linear 是分幾次、每次切一樣多的流量過去;canary 是先切一小部分,沒問題再切剩下的。兩者都支援 ALB 和 Service Connect,用 CloudWatch alarm 偵測失敗、自動回滾。
滾動更新只有兩個參數,官方文件的定義:
minimumHealthyPercent:更新期間最少要有幾 % 的 task 在跑且健康,無條件進位。desired 是你要這個服務維持的 task 數量。desired 4、設 50,排程器(ECS 裡決定先停哪個、再起哪個 task 的那一層)可以先停 2 個再起 2 個新的。maximumPercent:更新期間最多能有幾 % 的 task,無條件捨去。desired 4、設 200,可以先起 4 個新的再停 4 個舊的。
只能寫百分比,不像 K8s 的 maxSurge / maxUnavailable 還能寫絕對數量。文件特別標了一條:兩個值要讓排程器至少能停一個或起一個 task,不然部署會卡住。舉例:desired 2、minimumHealthyPercent 75%,2 × 75% = 1.5,進位成 2,所以一個舊的都不能先停。這時如果 maximumPercent 是 100%,2 × 100% = 2,也不能多起一個新的。不能停也不能起,部署就動不了。
斷路器:讓失敗的部署自己退
ECS 有內建的 deployment circuit breaker,官方文件:它分兩階段判定——先看 task 有沒有到 RUNNING,再看 health check(ALB、Cloud Map、容器的)有沒有過;失敗到門檻就把部署標成 FAILED,開了 rollback 選項會自動回到最近一次 COMPLETED 的部署。
aws ecs create-service ... \
  --deployment-configuration "deploymentCircuitBreaker={enable=true,rollback=true}"
兩件要知道的:門檻預設是 desired count 的 50%、夾在 3 到 200 之間,desired 只有 1 個 task 時門檻是 3——也就是連續三次起不來才回滾。還有:如果從來沒有一次 COMPLETED 的部署(第一次部就壞),沒有東西可以回,部署會卡住,第一次部署要盯著。
要不要自己開,看你從哪裡建服務。 從主控台建服務時,預設就勾了斷路器和「Rollback on failures」。用 API、CLI 或 IaC(把基礎設施寫成程式碼檔來建的做法)建的話,deploymentCircuitBreaker 裡的 enable 和 rollback 都是必填欄位,要像上面那樣明確寫 enable=true,rollback=true。(未查證:完全不帶 deploymentConfiguration 時 API 端的實際預設值,官方文件沒有明寫。)
還有一條範圍限制:官方文件寫斷路器和 CloudWatch alarm 回滾只支援滾動更新和藍綠部署。CodeDeploy 管的藍綠用不到它;linear 和 canary 的公告只提到用 CloudWatch alarm 回滾。
部署失敗會發 EventBridge 事件 SERVICE_DEPLOYMENT_FAILED,接到告警——這條進 第 7 篇的八條裡。
③ Migration:交付鏈裡最危險的一段
這段最常被整段跳過,而我的經驗是,出事的幾乎都在 ③。資料庫變更要跟程式碼變更解耦,而且要向前相容——因為滾動更新期間新舊版程式同時在跑。migration 跑完、舊版還在服務、舊版看到它不認識的 schema → 炸。
拆三步,每一步都可以獨立回滾:
| 步 | 做什麼 | 新舊版都能跑嗎 |
|---|---|---|
| Expand | 只加不改不刪:加欄位、加表、加索引 | ✅ 舊版不理新欄位 |
| Migrate | 部署新版,開始寫新欄位;背景回填舊資料 | ✅ |
| Contract | 確認沒人用舊欄位了,才刪 | ✅ 此時只剩新版 |
改欄位名 = 加新欄位 + 雙寫 + 回填 + 切讀 + 刪舊欄位,五步,不是一句 RENAME COLUMN。
在 ECS 上 migration 不要放在應用容器的啟動指令裡——50 個 task 同時起就 50 個搶著跑。用獨立的一次性 task:
- name: Run migration
  run: |
    aws ecs run-task --cluster prod-cluster --launch-type FARGATE \
      --task-definition web-app-migrate \
      --network-configuration "awsvpcConfiguration={subnets=[subnet-private-1a],securityGroups=[sg-app]}" \
      --overrides '{"containerOverrides":[{"name":"app","command":["npm","run","migrate"]}]}'
# 等它跑完、檢查 exit code,再進 deploy而且要有鎖:兩個 migration 不能同時跑。
老實講:多數 migration 沒有真正的回滾,刪掉的資料回不來。能退的是 Expand——把加上去的欄位刪掉就回到原狀;Contract 那步先備份再刪,回滾等於還原備份。沒把握的 migration,先在 staging 用正式資料的複本跑一次、計時。
⑤ 驗證與環境晉升
「部署成功」不是 ECS 說 steady state,是三件事:部署期間持續打流量全程零 5xx、部署後的錯誤率和 p99 跟部署前一樣或更好、實際回滾過一次並計時。第三條最常被跳過——沒演練過的回滾不算有。
零 5xx 的前提在 第 4 篇:deregistration delay、ECS 的 stopTimeout、程式的 graceful shutdown 三個時間要對齊。
環境晉升用同一個 image:
staging(每個 merge 自動部)→ UAT(手動觸發,業務驗)→ production(手動觸發 + 審核)
                    同一個 SHA 一路往上,不是每個環境各自 build
GitHub 的 Environment 機制做審核:environment: production 設 required reviewers,production 那個 job 會停下來等人按。設定差異用 Parameter Store 注入,不進 image。
誰能部署
部署這個動作本身也要管。每次部署都要留下稽核軌跡:誰、什麼時候、部了哪一版。prod 部署要兩個人,一個是提交的人,一個是審核的人;上面 Environment 的 required reviewers,就是讓審核的人按下去的地方。緊急部署的例外流程也要事先寫好,不是出事時現想。
OIDC:不存 key
permissions:
  id-token: write
steps:
  - uses: aws-actions/configure-aws-credentials@v4
    with:
      role-to-assume: arn:aws:iam::123456789012:role/github-actions-deploy
      aws-region: ap-northeast-1
IAM 那邊建 OIDC provider 指向 token.actions.githubusercontent.com,role 的信任政策用 sub 條件鎖到特定 repo 的特定分支:
"StringLike": {"token.actions.githubusercontent.com:sub": "repo:your-org/web-app:ref:refs/heads/main"}不鎖 sub 的話,同一個 GitHub 組織的任何 repo 都能 assume 這個 role。
舊教學會叫你手抄一串 thumbprint——IAM 文件現在說 AWS 用自己的受信任根憑證庫驗證 OIDC 端點,thumbprint 只在驗不了時當備援;console 建的時候會自動抓,不用手抄。
CodePipeline:只剩一種情況才選
原本的兩種情況,第一種是要 CodeDeploy 的藍綠部署(整套新環境起好、一次切流量、秒級切回)。但 ECS 從 2025 年 7 月起自己就有原生藍綠(見 ④),不用 CodeDeploy 也做得到,這個理由已經被削弱。第二種是合規要求整條鏈不能出 AWS。其他時候 GitHub Actions 就好:YAML 清楚、社群 action 多、debug 不用在三個服務之間跳。
兩邊的差別:GitHub Actions 學習曲線低、一份 log 就 debug 完、審核用 Environment reviewers。CodePipeline 要串三個服務,debug 時在三個 console 之間跳。它原本的優勢是藍綠部署由 CodeDeploy 原生支援,不過現在 ECS 也有了。
這篇的驗證標準
| 主張 | ❌ 不算 | ✅ 算 |
|---|---|---|
| 能回滾 | image 有 SHA tag | 實際回滾一次、計時,且回滾後的 image 確實是上一版 |
| 部署不中斷 | ECS 顯示 steady state | 部署期間持續打流量,零 5xx |
| migration 安全 | 有 expand/contract 的文件 | 新舊版同時跑過一次,舊版沒炸 |
| 斷路器有用 | 設定開了 | 故意部一個起不來的 image,看它自己退回去 |
實戰 Checklist
- tag 用 git SHA;ECR 開 IMMUTABLE;lifecycle 保留最近 N 版
- 部署 = 註冊新 revision,不是 force-new-deployment
- 斷路器
enable=true,rollback=true;第一次部署有人盯 - migration 是獨立 RunTask,expand → migrate → contract
- 同一個 SHA 一路晉升;production 要人按;OIDC 的
sub鎖到 repo 和分支
從 K8s 過來的話
image SHA tag、不可變 registry、expand/contract 這三件跟 K8s 完全一樣。差別在回滾的機制:K8s 是 kubectl rollout undo,ECS 是指回上一個 task definition revision;K8s 的 Deployment 有 progressDeadlineSeconds 判失敗,ECS 是斷路器。ArgoCD 那套 GitOps 在 ECS 上沒有對應——ECS 是推式部署,pipeline 主動呼叫 API。用 EKS 才有 ArgoCD 的路,見 K8s GitOps。
相關文章
好的 CI/CD 讓你有信心在週五下午部署——因為你知道退得回去。